打开手机下载APP时,会看到“正在加速加载资源”的提示,这个过程其实就和爬虫工作有点像——只不过爬虫是帮网站抓取数据的“数字搬运工”,而限速设置就是给这个“搬运工”定的“作息规矩”。如果规矩太松,搬运工一窝蜂挤去仓库,不仅会把货架碰倒(网站服务器崩掉),还会偷拿别人的东西(违规抓取);规矩太紧,搬运工磨磨蹭蹭,半天搬不完货(爬取效率极低)。今天就聊聊,怎么给爬虫设个“舒服的限速”,既能合规又能高效干活。
先搞懂:爬虫限速到底限什么?
很多人以为限速就是“放慢速度”,其实没那么简单。爬虫的请求是给网站发的“取数据信号”,每次信号对应一次交互,所以限速的核心是控制“信号发送的频率”和“单次发送的量”。举个生活化的例子:你去超市买东西,要是一分钟跑5次柜台,收银员肯定不耐烦(服务器过载);要是10分钟跑一次,你可能当天的事儿都办不完(效率太低)。所以限速的本质,是找“不打扰别人的最快节奏”。
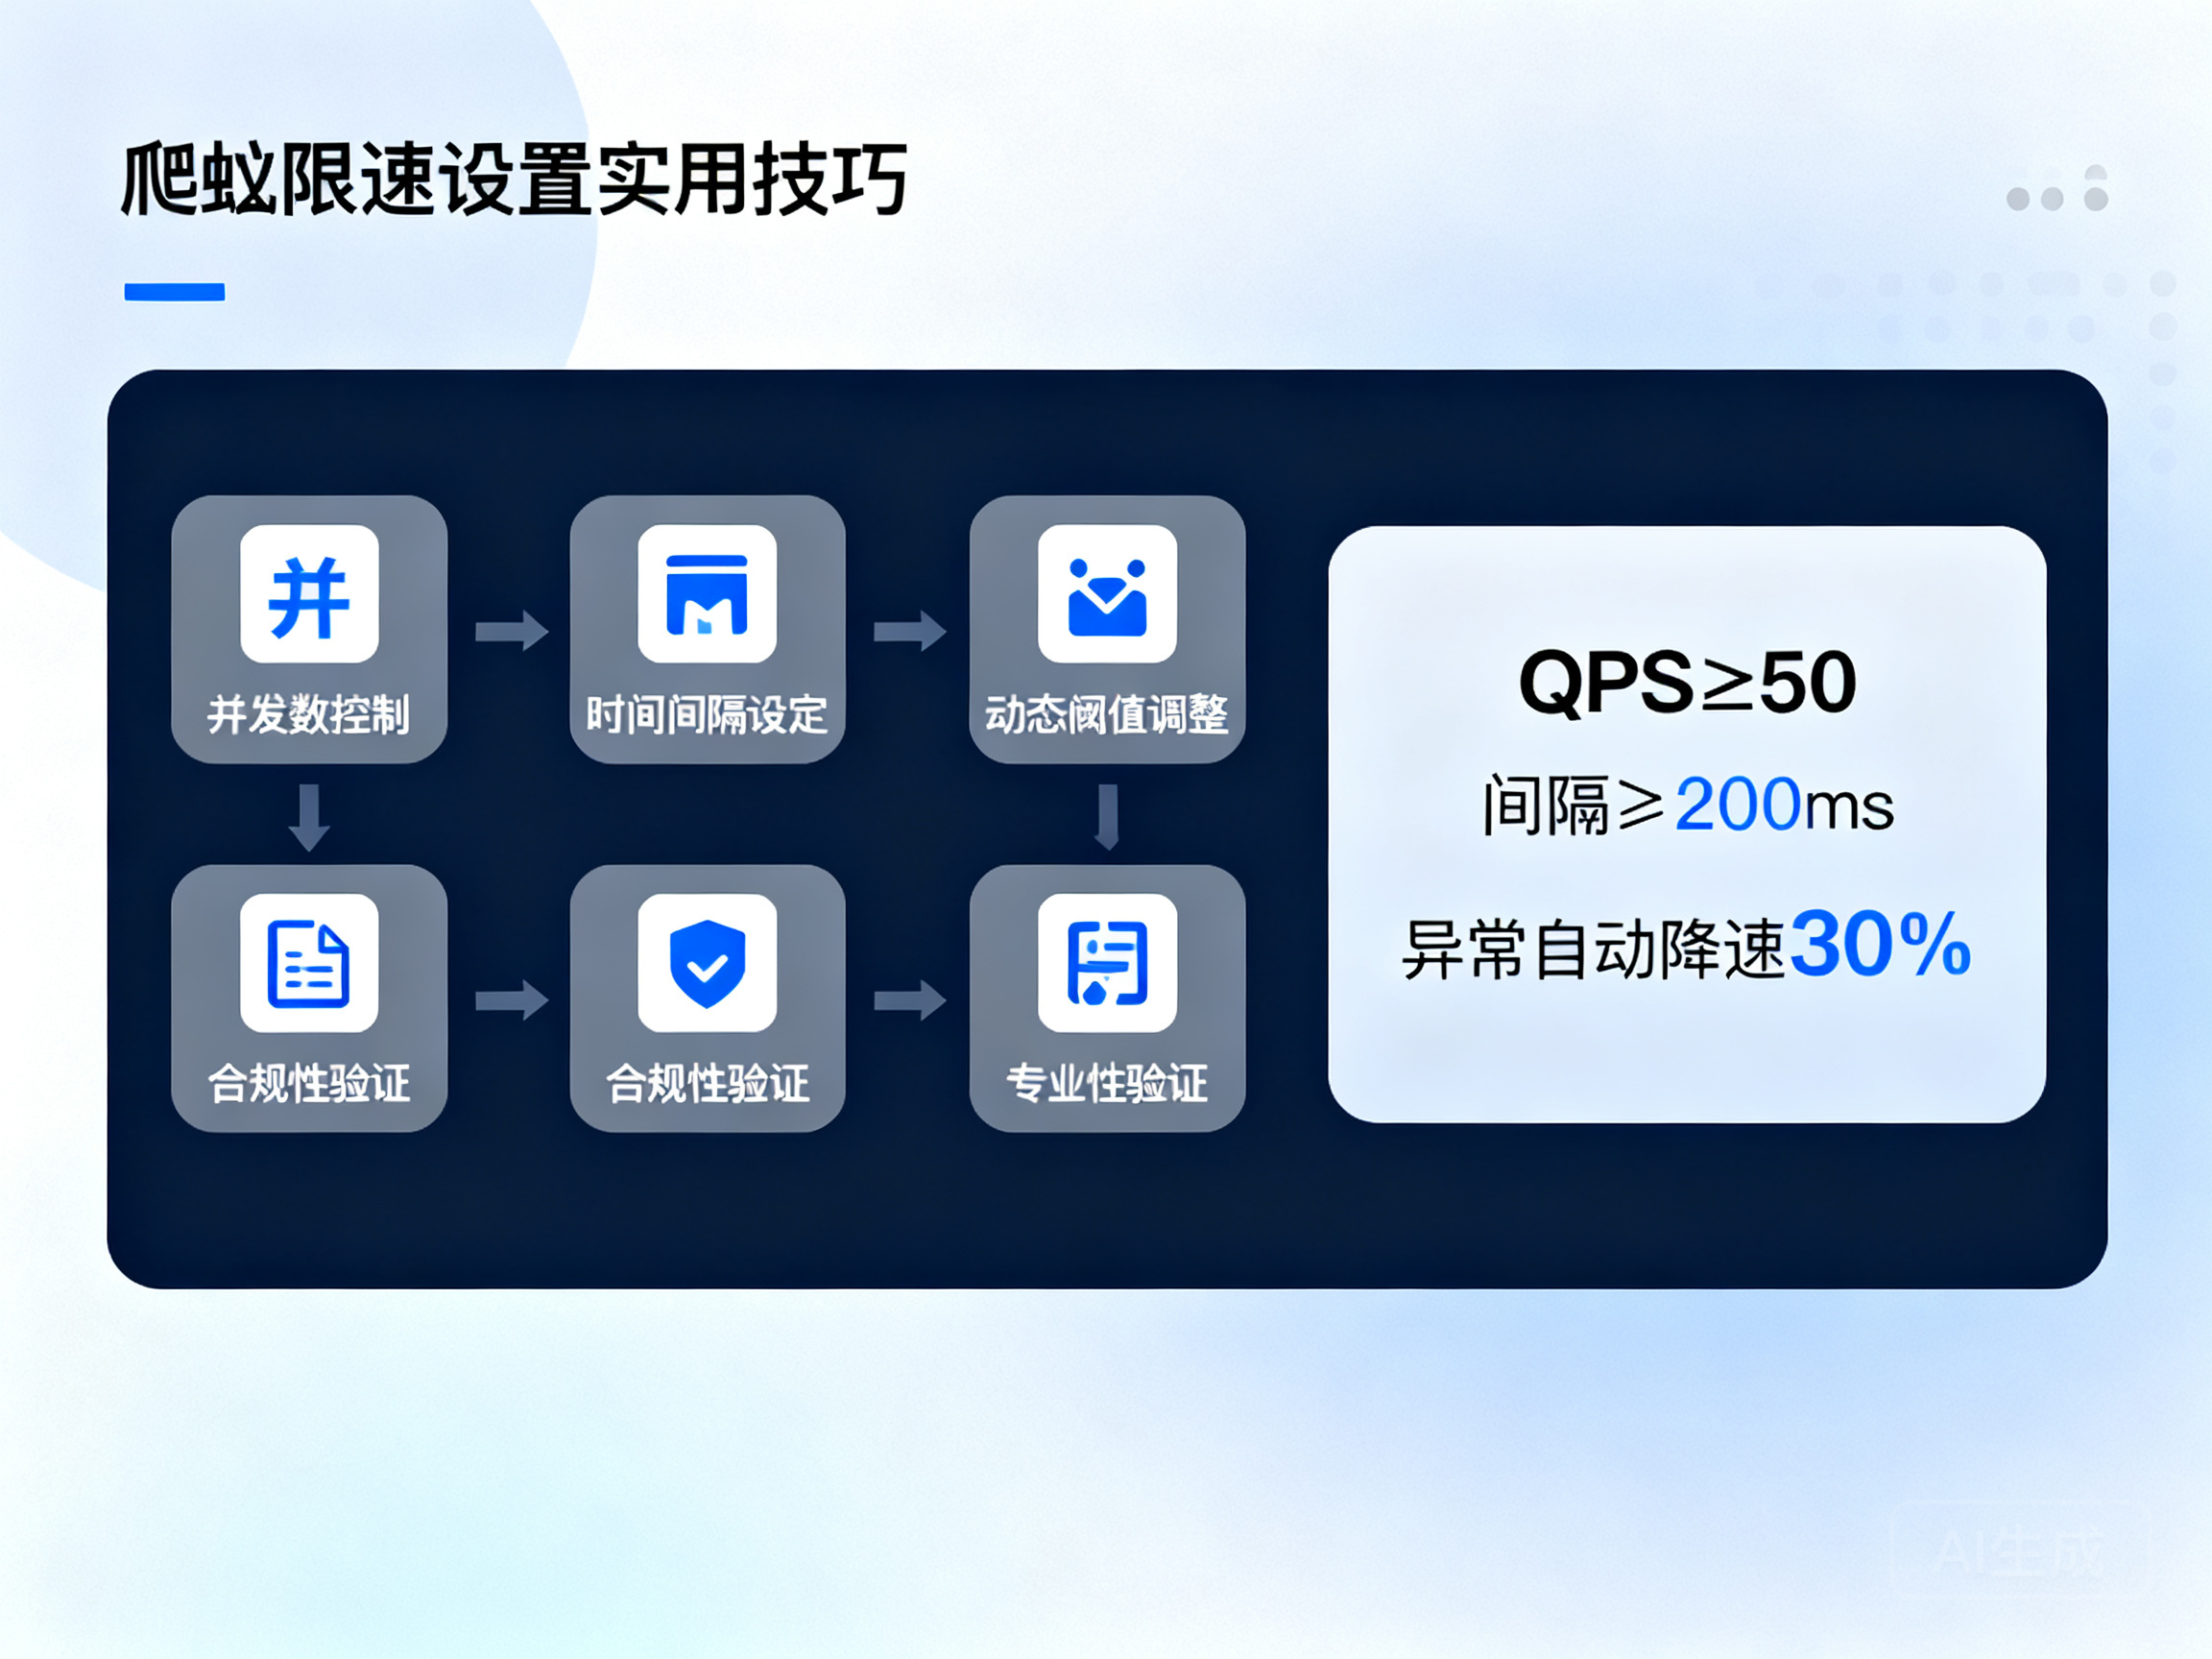
常见的限速对象有两种:一种是“时间间隔限速”——比如每次发完请求后,固定等2秒再发下一次,相当于给爬虫定“每2秒喝口水再干活”;另一种是“并发限速”——同一时间最多发3个请求,就像你一次只推3辆购物车,不会占满通道。
实用技巧1:用“礼貌间隔”代替“固定死速度”
很多新手会直接设“每3秒发一次请求”,但这种“死规矩”容易出问题——要是某段时间网站服务器忙(比如618活动时),你还硬卡3秒,其实是在给服务器添乱;要是网站空着,你按3秒爬就太浪费时间。
更聪明的做法是设“动态礼貌间隔”:每次请求后,等的时间不是固定的,而是根据网站的响应速度调整。比如网站这次响应快(1秒就返回数据),就等1.5秒;要是这次响应慢(3秒才返回),就等5秒。就像你和朋友聊天,对方秒回你就别催,对方半天没理,你过会儿再问,既礼貌又高效。
很多爬虫工具(比如Python的Requests库)都能简单实现这个逻辑,不用写复杂代码,只要加个时间判断就行。
实用技巧2:给“敏感路径”单独设限速
网站上不是所有内容都一样重要,像用户手机号、订单地址这类隐私内容,网站会设专门的防护(反爬机制),要是你和爬商品介绍一样的速度爬隐私路径,大概率会被拉黑。
所以得给不同路径“量身定做限速”:爬商品列表、新闻这类公开内容,间隔可以设1-2秒,并发设3-5个;爬评论、用户动态这类中等敏感内容,间隔改成2-3秒,并发减到2个;要是碰着带“/admin”“/user”的后台路径,直接把间隔拉到10秒以上,甚至手动控制请求频率。
就像你去图书馆,公共阅览区可以随便看,但古籍特藏区得轻手轻脚,不能大声翻书,这就是路径限速的意义。
实用技巧3:留好“缓冲地带”应对突发情况
就算你把限速设得再精准,也可能碰到意外:比如突然碰到网站的反爬触发了,或者自己的网络出了波动,这时候硬爬很容易被封,还可能漏掉数据。
所以要加“缓冲机制”:比如每爬100个请求,就自动暂停1分钟,让服务器喘口气;要是碰到429错误(网站说“你爬太快了”),就立刻把间隔翻倍,等5分钟再恢复,而不是继续硬闯。
还有个小细节:请求里一定要带“User-Agent”标识,告诉网站“我是合规的爬虫,不是恶意机器人”,这样网站会给你留更多空间,不会随便限制。
最后:限速的核心是“双赢”
很多人觉得爬虫限速是“给自己找麻烦”,其实不是——网站要保护数据不被恶意抓取,我们要高效拿到需要的内容,限速就是找两者的平衡点。就像快递员送货,既不能抢着闯红灯(恶意爬取),也不能慢悠悠一天只送一单(效率太低),定个合理的时间和路线,才能既不被交警罚,又能按时送完所有快递。
只要把限速的逻辑搞懂,不用怕爬虫效率低,也不用担心违规,反而能把爬虫的作用发挥到最大。